Blog · AI agenti · dynamické workflow
10, 20, nebo neomezeně agentů?
Stejné zadání, různé stropy na počet agentů. Jde o to, jak se tím změní celý návrh workflow. Ukážu to na dvou případech: na aplikaci pro Slack a na infrastrukturním úkolu.
Když dám agentovi velký úkol, nechci, aby ho celý sám odpracoval v jednom dlouhém kontextu. Chci, aby ho rozdělil. K tomu používám dynamické workflow: agent napíše TypeScript skript, který za běhu spouští další agenty, paralelizuje je, řadí do pipeline a ověřuje jejich práci.
Ještě nedávno by to nedávalo smysl. Rozvrh práce musel navrhnout člověk: rozkreslit fáze, určit, co poběží paralelně, a napsat pevnou šablonu, do které se úkol nasype. Dnešní modely tohle zvládají samy a dobře. Umí odhadnout, kde jsou v zadání přirozené švy, rozdělit kód na disjunktní části, aby si agenti nešlapali do souborů, a poznat, které kroky na sobě závisí a které můžou běžet vedle sebe. Umí taky naplánovat kontrolu: kde nasadit nezávislého reviewera, kde stačí měření a kde se vyplatí smyčka oprav.
Proto nedává smysl jim tvar workflow předepisovat. Pevná šablona je kompromis pro průměrný úkol, a ten skoro nikdy nedostanu. Slack aplikace potřebuje jiný rozvrh než změna živého clusteru a malý úkol jiný než velký. Když plánování nechám na modelu, šablonu nahradí rozhodnutí šité na konkrétní zadání. Já určuji jen mantinely: rozpočet, strop na počet agentů a pravidla bezpečnosti.
Otázka, kterou jsem si položil, je jednoduchá: co se stane s tím tvarem, když agentovi dám strop na počet agentů, a co když ne?
Případ 1: Slack aplikace
Zadání
Postav Slack aplikaci na ankety inspirovanou aplikacemi Polly a Simple Poll. Python, SQLite, Dockerfile a Kubernetes manifesty. Zadání je v obou případech totožné, liší se jen tím, co agent smí.
slack-polls-10.workflow.ts: tvrdý limit 10 agentů, vynucený v kódu.slack-polls-max.workflow.ts: bez limitu, jen pojistka na 180 agentů, kdyby se něco zacyklilo.
Varianta A: deset agentů
Limit není pouhé doporučení v promptu. Každé spuštění agenta jde přes funkci run(), která počítá spuštěné agenty. Jakmile dojde rozpočet, další krok se přeskočí a zapíše do logu.
const MAX_AGENTS = 10;

async function run(prompt, opts) {
  if (spawned >= MAX_AGENTS) {
    log(`Limit ${MAX_AGENTS} agentů vyčerpán, přeskakuji: ${opts.label}`);
    return null;
  }
  spawned++;
  ...
}
Když agent ví, že má deset slotů, naplánuje je velmi úsporně. Každý slot má jasnou roli a nic se neopakuje:
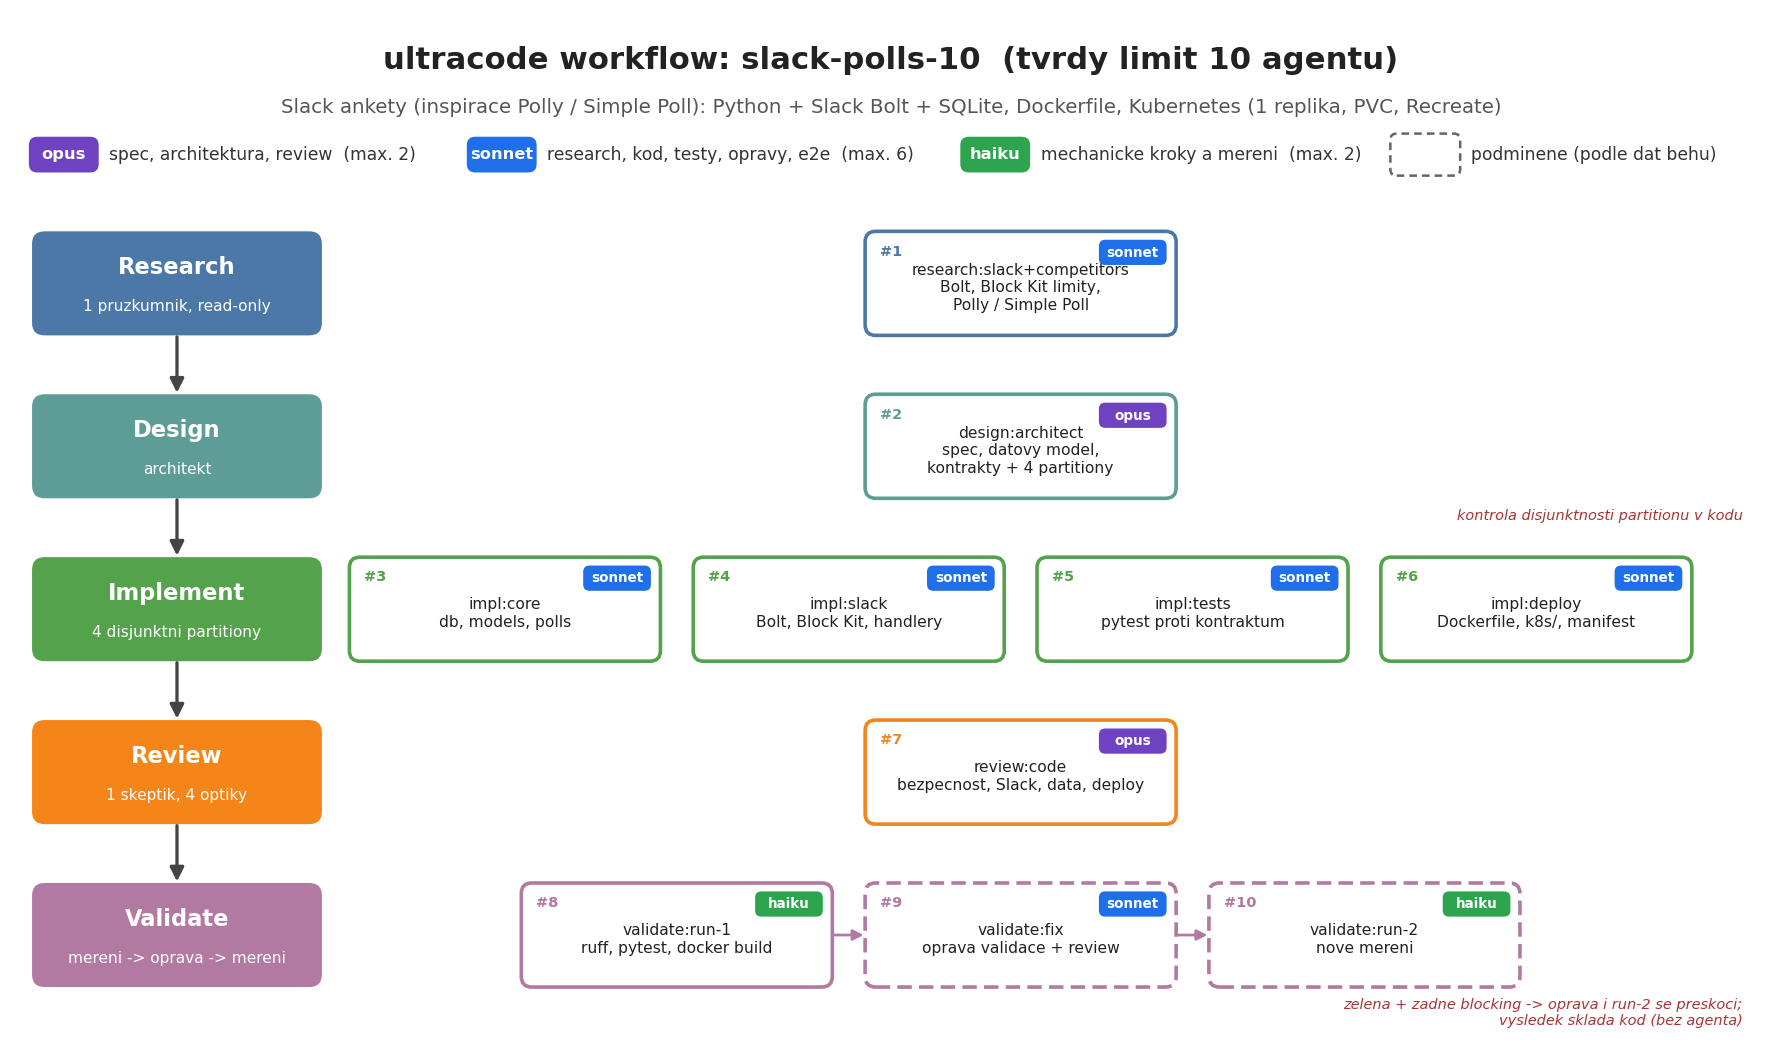
- 1× research (Sonnet): Slack Bolt, limity Block Kit, funkce konkurence.
- 1× architekt (Opus): specifikace, datový model, kontrakty modulů a rozdělení na čtyři disjunktní partitiony.
- 4× implementace paralelně (Sonnet):
core,slack,tests,deploy. - 1× skeptický reviewer (Opus): bezpečnost, limity Slacku, data, deploy.
- Validace: měření (Haiku), oprava (Sonnet), nové měření (Haiku).
Poslední tři kroky jsou podmíněné. Pokud je první měření zelené a reviewer nenajde nic blokujícího, oprava i druhé měření se přeskočí.
Varianta B: bez limitu
Bez stropu se změnila otázka. Agent se už neptá, kam se vejde, ptá se, kde se dá chyba chytit dřív a levněji. Výsledkem je mnohem hlubší pipeline:
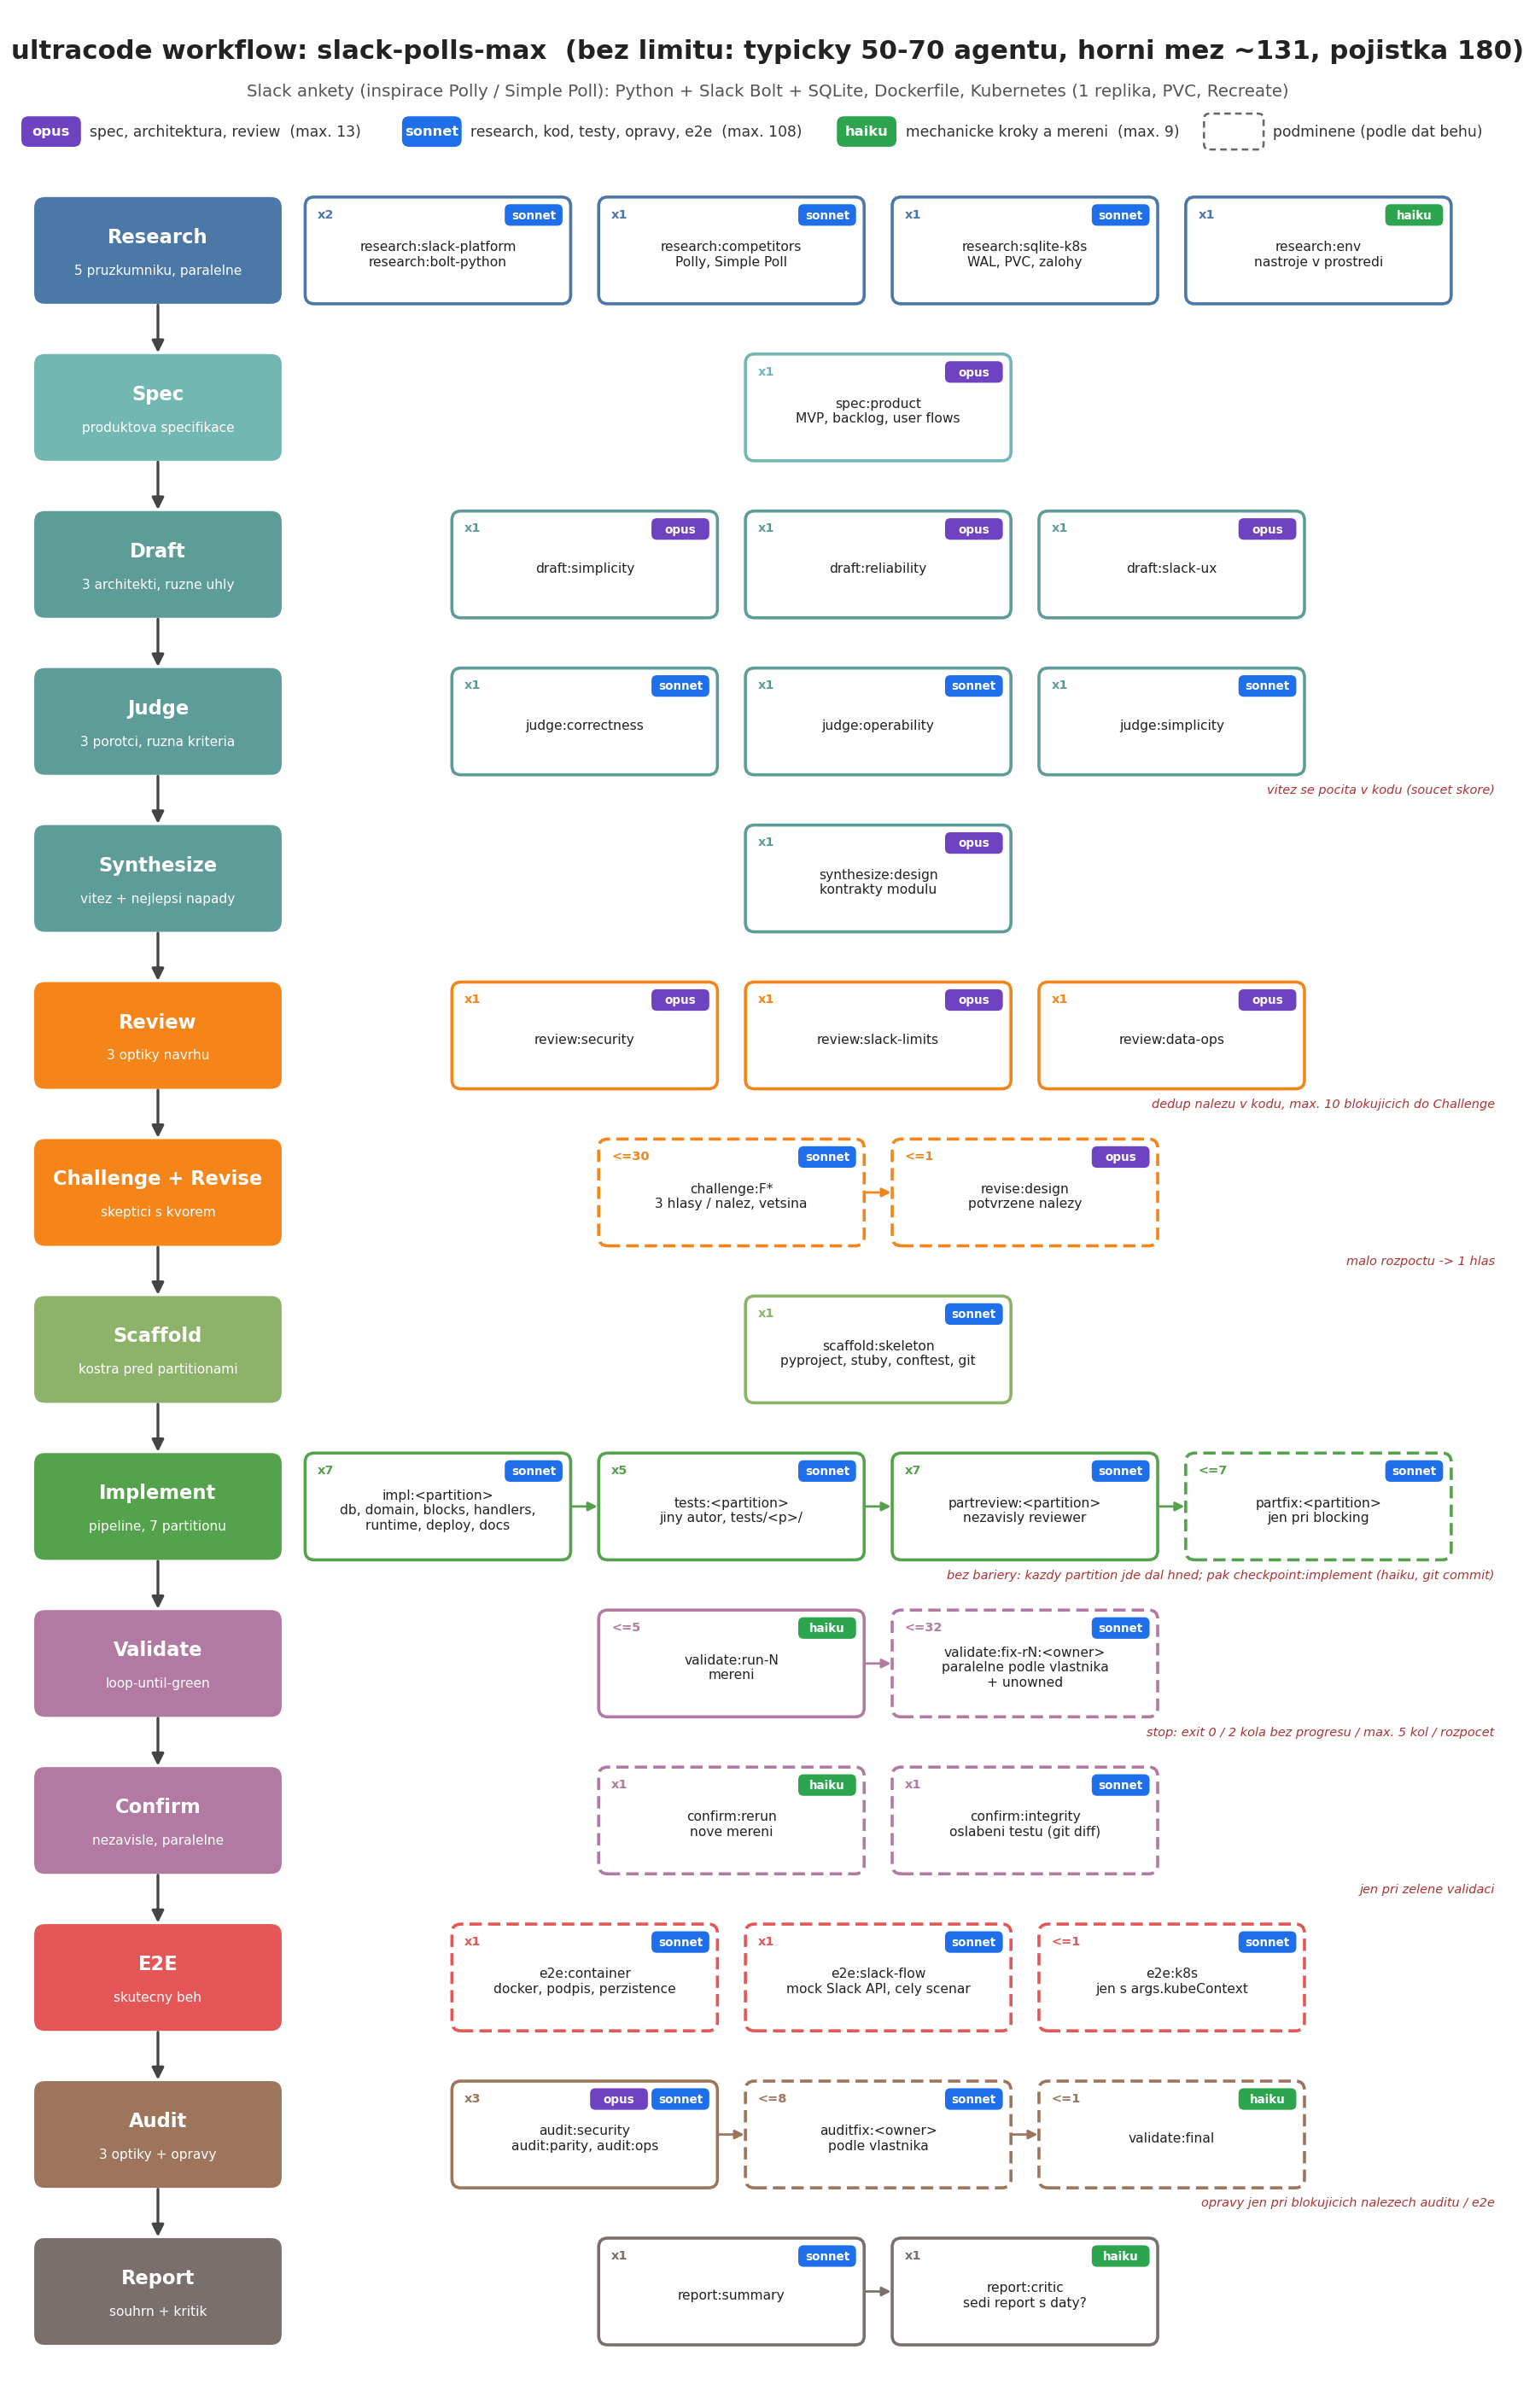
Hlavní rozdíly oproti desetiagentní verzi:
- Panel místo jednoho názoru. Tři architekti navrhnou řešení z různých úhlů (jednoduchost, spolehlivost, UX ve Slacku). Tři porotci je hodnotí podle různých kritérií a vítěze spočítá kód ze součtu skóre, ne další agent.
- Skeptici s kvórem. Každý blokující nález z review návrhu zkoumají tři nezávislí agenti a platí většina. Slabé nálezy tak neprojdou do revize.
- Pipeline místo bariéry. Sedm partitionů se implementuje, testuje jiným autorem, reviduje nezávislým reviewerem a opravuje. Každý partition jde dál hned, jak je hotový, a nečeká na ostatní.
- Loop-until-green. Validace běží až pět kol, opravy se dělí podle vlastníka souboru. Smyčka skončí při exit kódu 0, po dvou kolech bez pokroku nebo po vyčerpání rozpočtu.
- Nezávislé potvrzení. Zelený výsledek znovu změří jiný agent a další zkontroluje
git diff, jestli oprava jen neoslabila testy. - E2E a audit. Běh v kontejneru, celý Slack flow proti mock API a finální audit třemi optikami. Na konci souhrn a kritik, který ověří, že report sedí s daty.
Poměr modelů zůstává podobný v obou variantách. Opus dělá rozhodnutí s největším dopadem (architektura, syntéza, bezpečnostní audit), Sonnet kód, testy a opravy, Haiku mechanické spouštění a měření. Roste hlavně počet Sonnetů, protože ten se násobí s počtem partitionů a kol.
Srovnání
| 10 agentů | Bez limitu | |
|---|---|---|
| Agentů | 10 | typicky 50 až 70, strop návrhu 130 |
| Návrh | jeden architekt, jeden názor | 3 návrhy, 3 porotci, syntéza |
| Review | 1 skeptik, 4 optiky | 3 optiky návrhu, review každého partitionu, audit na konci |
| Spor o nález | rozhoduje reviewer | kvórum 3 hlasů |
| Opravy | jedno kolo | až 5 kol, oprava podle vlastníka |
| Testy | píše je jeden agent paralelně s kódem | jiný autor než implementace, kontrola oslabení testů |
| E2E | lint, pytest a docker build | kontejner, Slack flow s mock API, volitelně kind |
| Selhání | krok se přeskočí, běh pokračuje | smyčky mají vlastní stop podmínky |
Případ 2: infrastruktura
Druhý případ je jiného druhu. Nevzniká nový kód, ale mění se živý systém, a tam se chyba platí jinak. Zadání: postavit Qdrant HA cluster (3 peery, replikace RF3, write consistency 2) v Kubernetes a přidat pravidelné snapshoty do S3 včetně ověření obnovy.
Tady jsem porovnal tři stropy: 10 agentů, 20 agentů a bez pevného limitu. U všech tří platí stejné pravidlo: nasazuje se jen do neprodukčního prostředí.
Varianta A: deset agentů
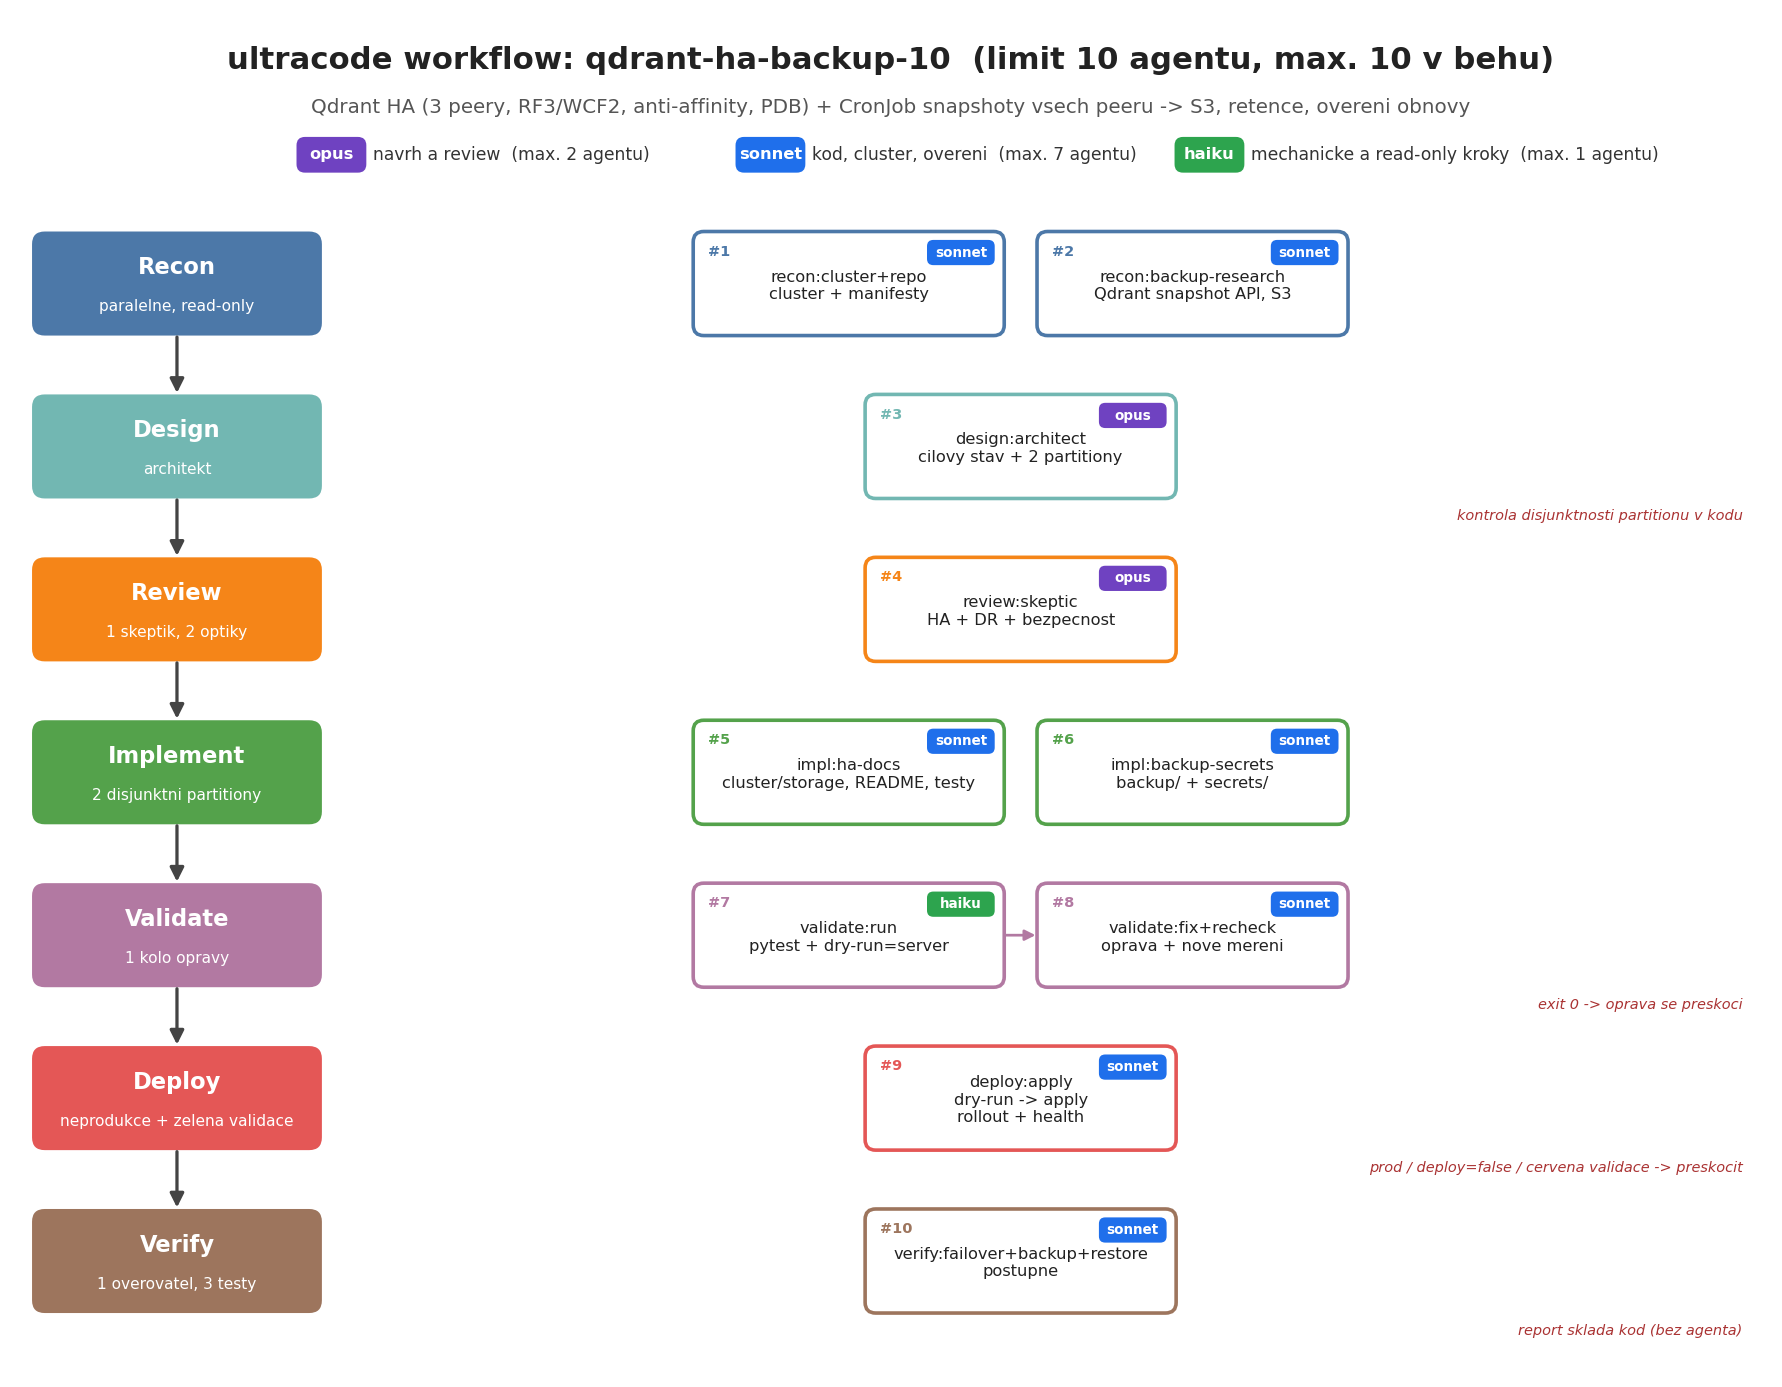
- Recon: dva průzkumníci, jeden pro cluster a repozitář, druhý pro zálohy a dokumentaci upstreamu.
- Design a review: jeden architekt a jeden skeptik, který projde HA, obnovu po havárii i bezpečnost najednou.
- Implement: dva implementátoři s disjunktními soubory.
- Validate: měření a jedno kolo opravy.
- Deploy a Verify: jedno nasazení a jeden ověřovatel, který postupně zkouší failover, zálohu a obnovu.
Všechno je jednou, nic se nezdvojuje. Tři různé testy dělá jeden agent, takže kdo test napsal, ten ho i vyhodnotí.
Varianta B: dvacet agentů
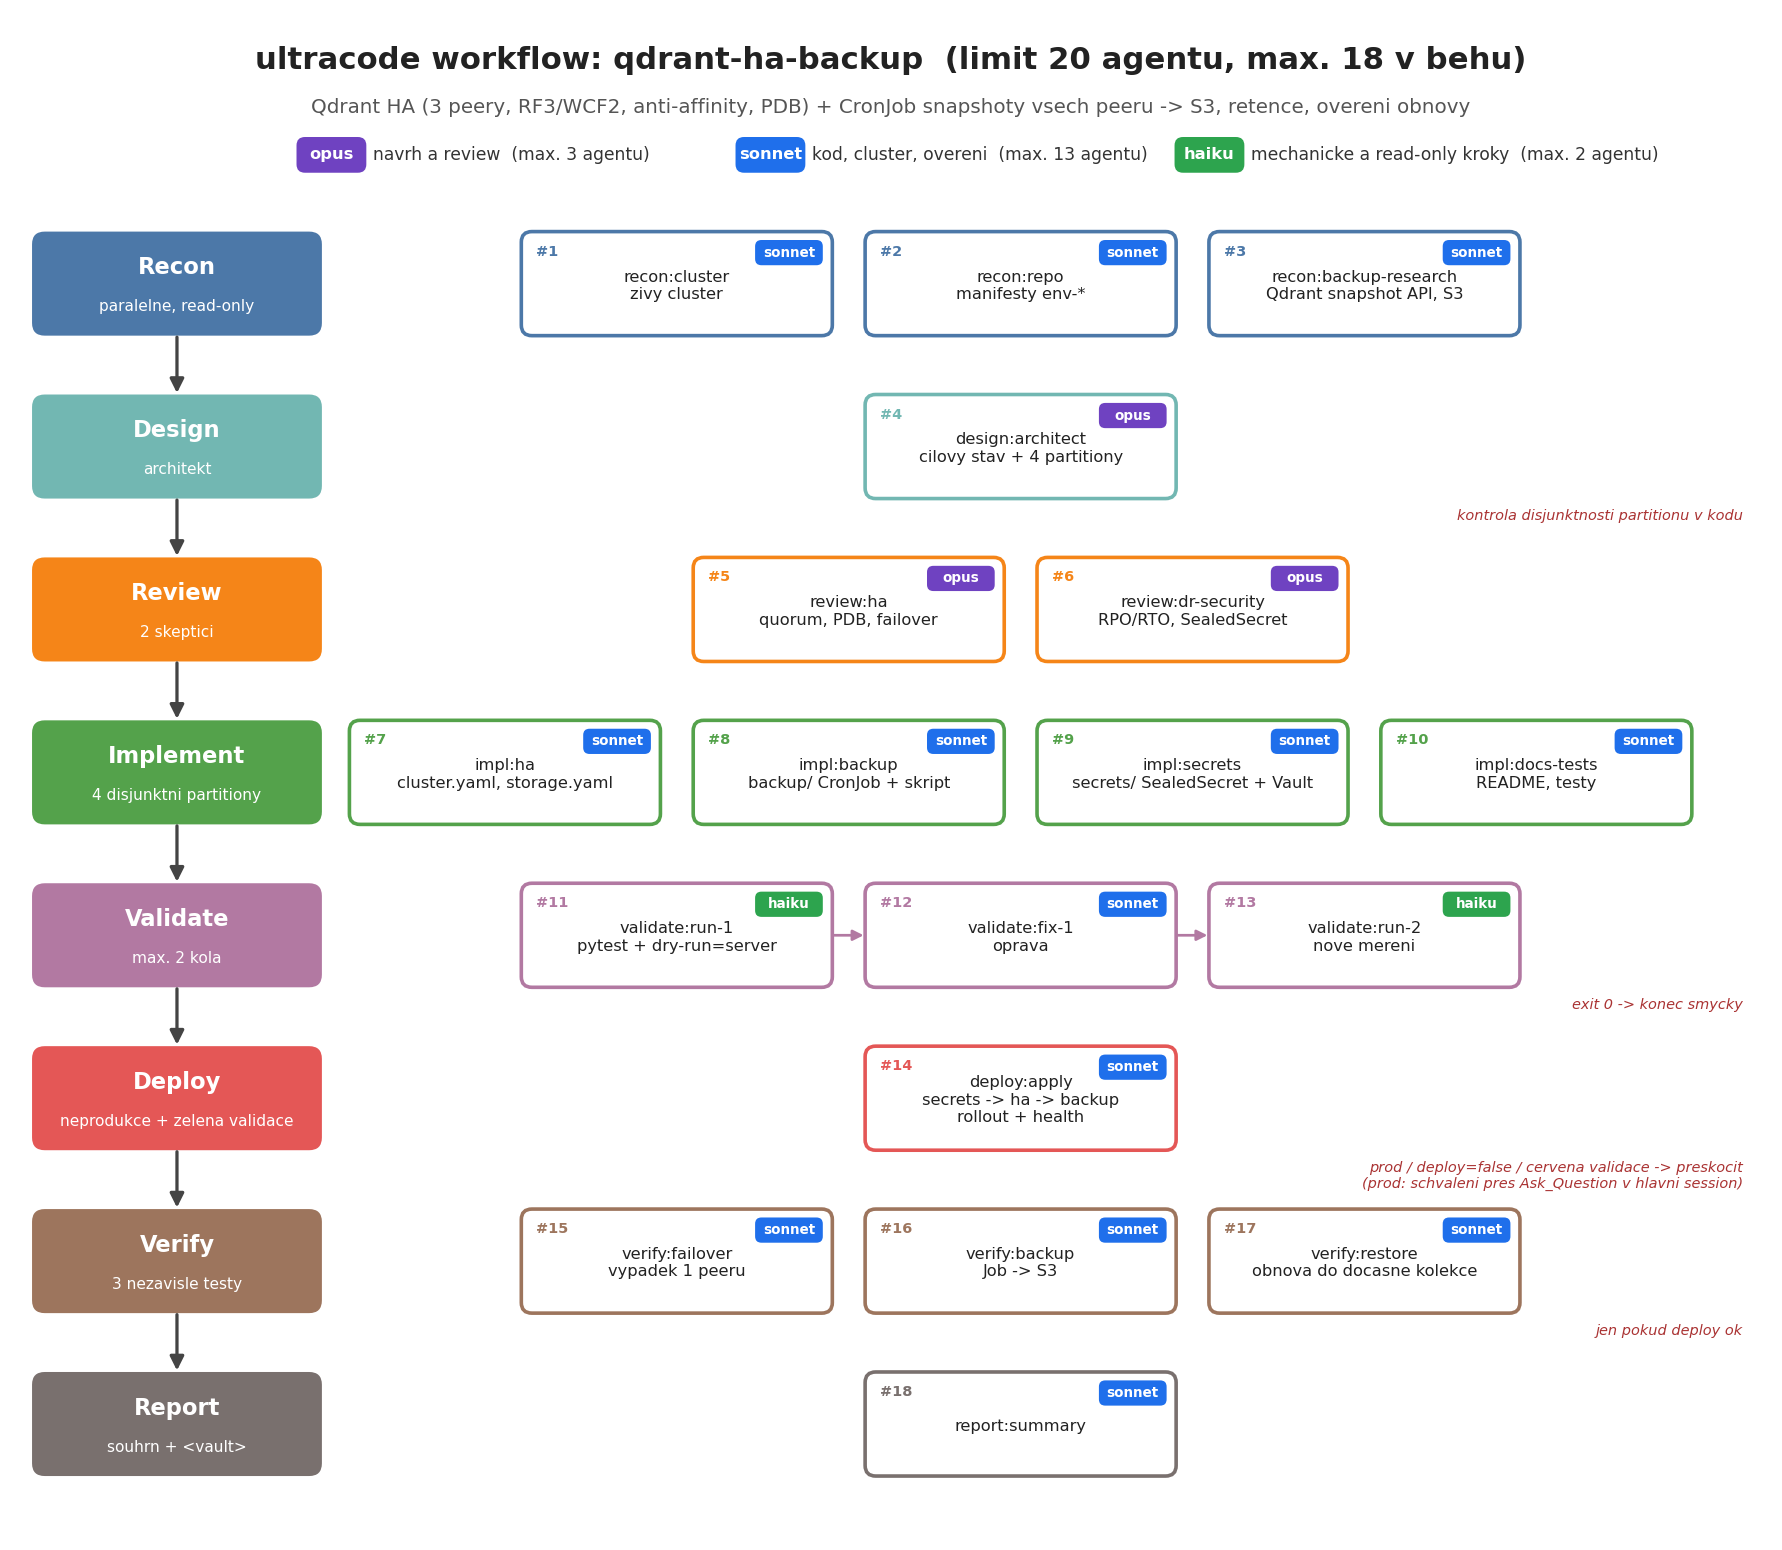
Rozdíl oproti desítce je poměrně jasný: rozpočet jde do rozdělení rolí, ne do hloubky.
- Průzkum se rozdělí na tři agenty: živý cluster, repozitář s manifesty a výzkum zálohování.
- Místo jednoho skeptika jsou dva se specializací: HA a failover, a obnova po havárii s bezpečností.
- Implementace se rozpadne na čtyři partitiony: HA, zálohy, secrets a dokumentace s testy.
- Validace může mít dvě kola.
- Ověření se rozdělí na tři nezávislé testy: výpadek jednoho peeru, běh zálohy do S3 a obnova do dočasné kolekce.
- Na konci je ještě souhrn.
Pořád je to ale lineární průchod. Žádná fáze se neopakuje, žádný nález se nepotvrzuje druhým názorem a výsledky testů už nikdo nepřepočítává.
Varianta C: bez pevného limitu
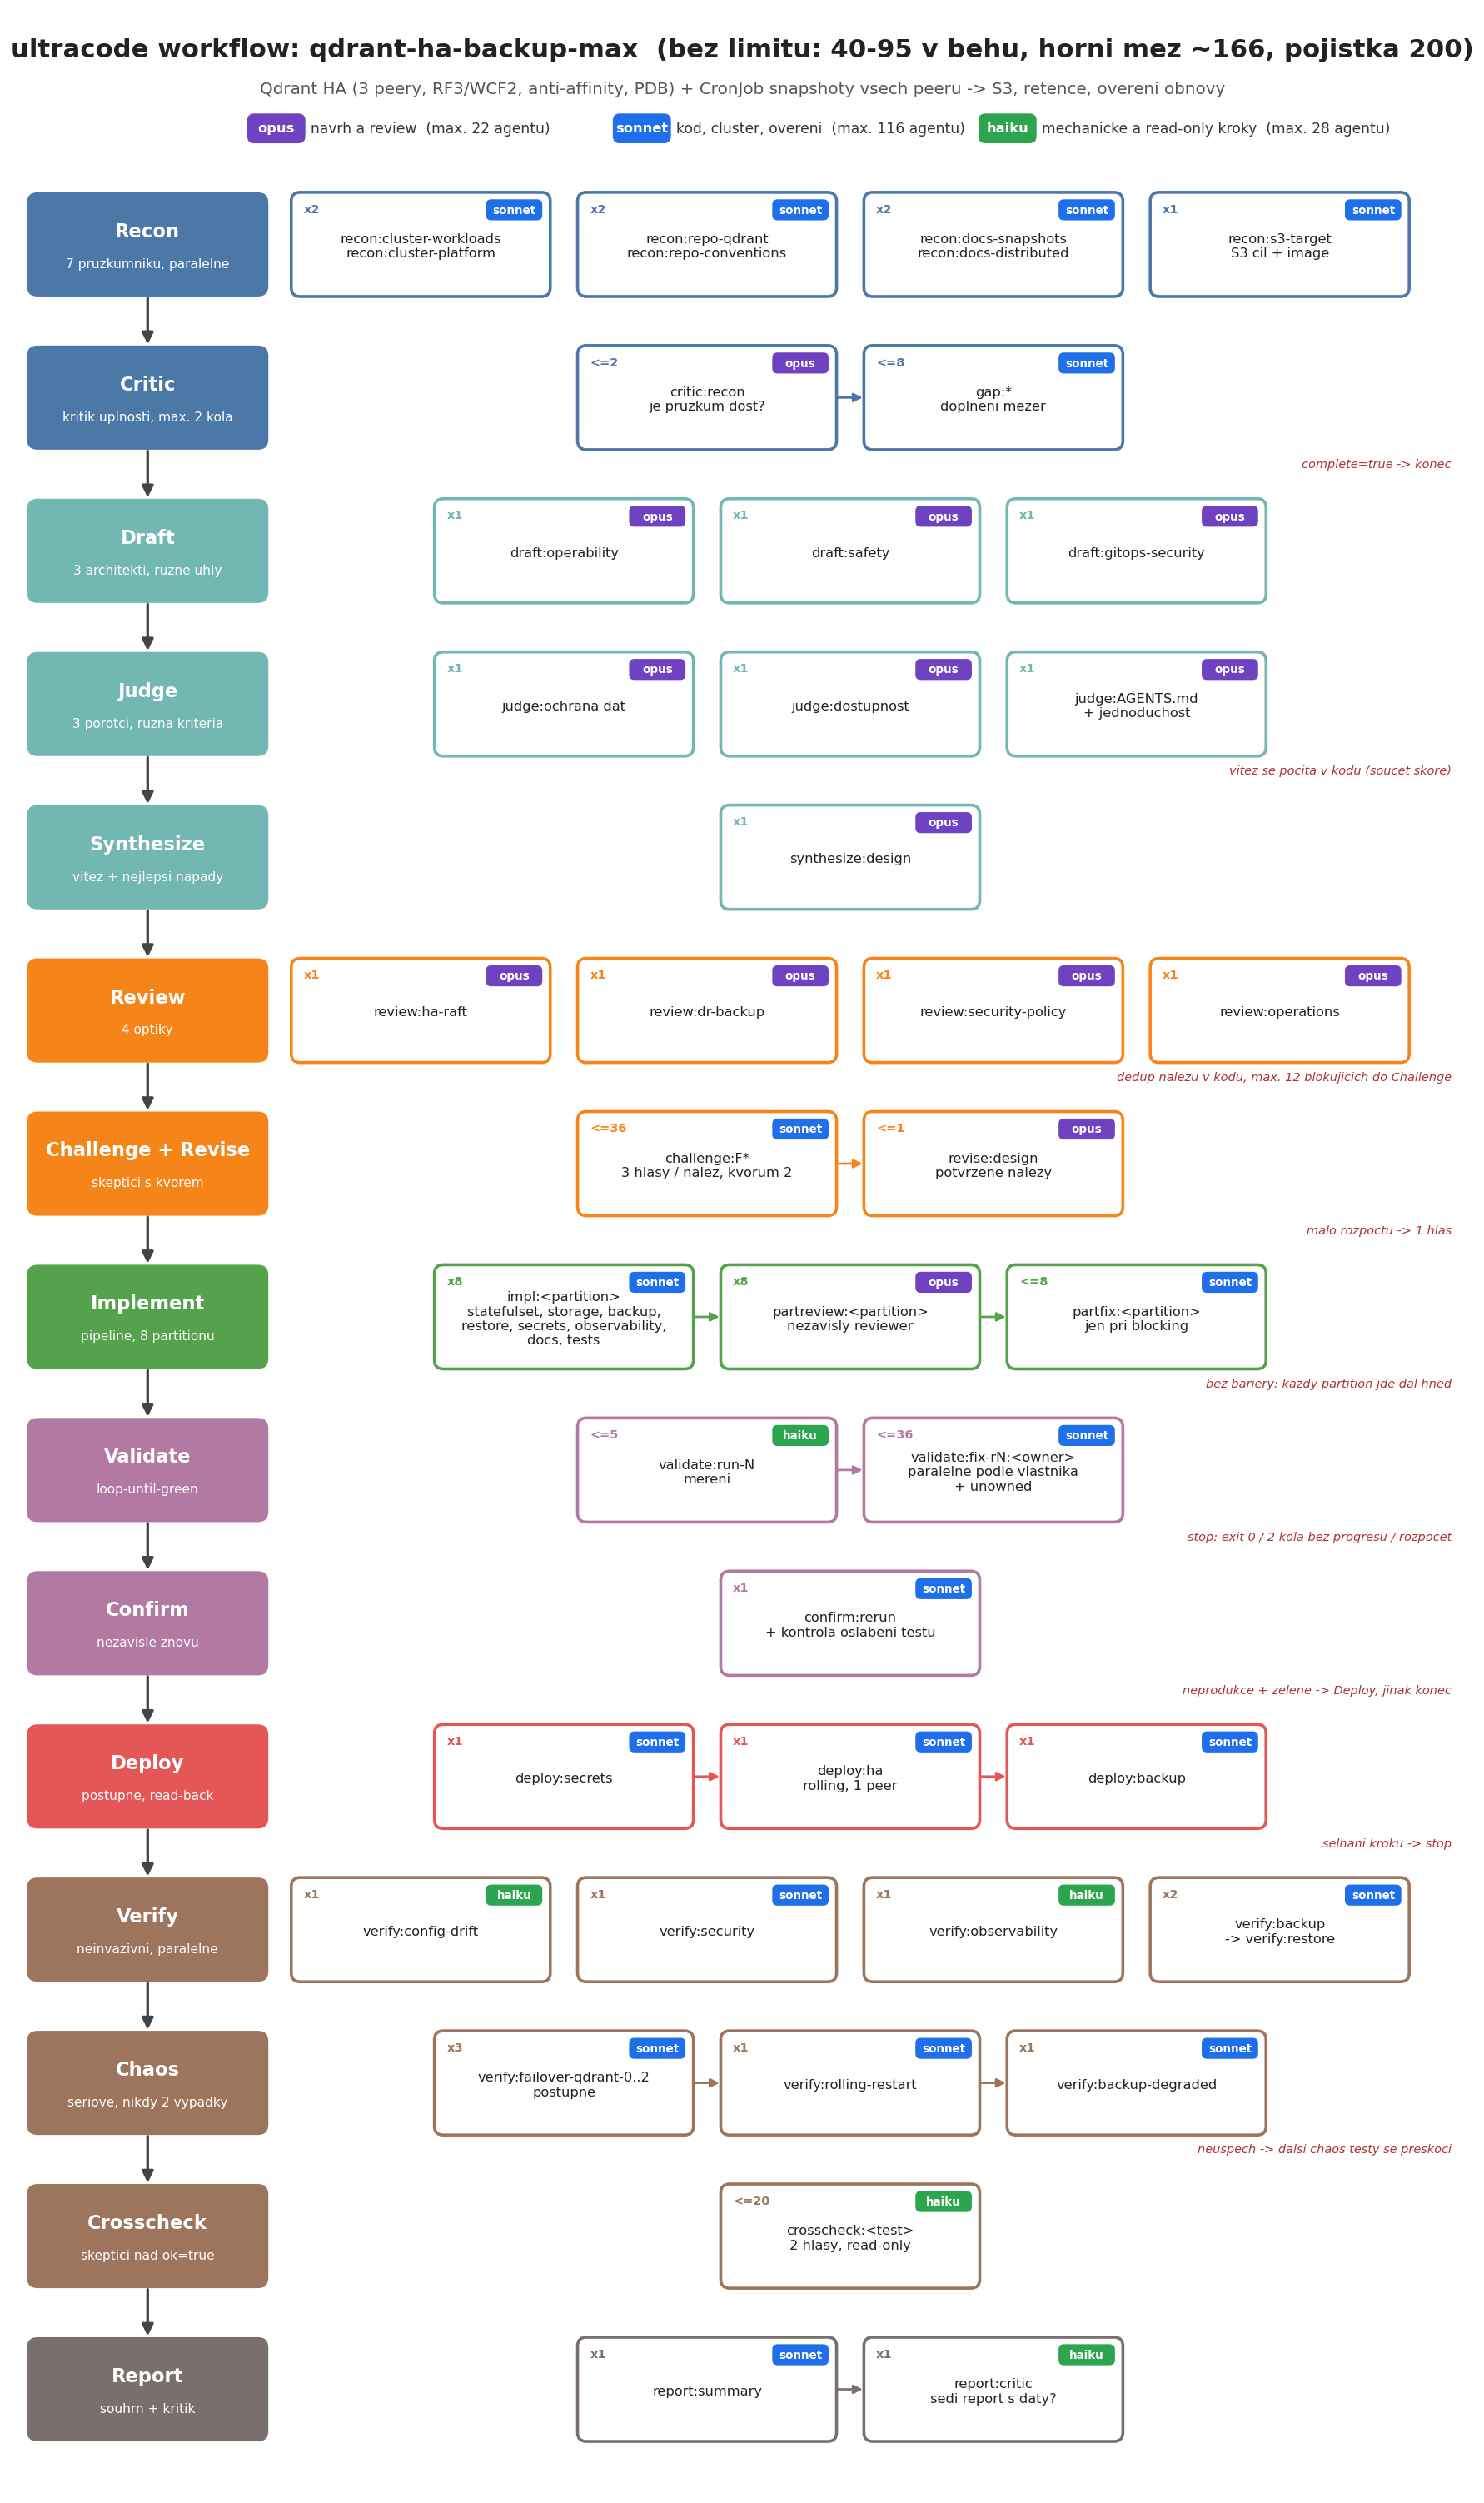
Bez stropu se přidávají celé vrstvy, které v menších variantách vůbec nejsou:
- Kritik průzkumu. Sedm průzkumníků z různých úhlů a pak agent, který se ptá, jestli je průzkum úplný. Když není, doplní se mezery, nejvýše ve dvou kolech.
- Panel a porota. Tři architekti (provozuschopnost, bezpečnost, GitOps), tři porotci s různými kritérii a vítěze počítá kód ze součtu skóre.
- Čtyři optiky review a skeptici s kvórem. Každý blokující nález ověřují tři agenti a platí většina.
- Osm partitionů v pipeline. Implementace, nezávislé review a oprava jen při blokujícím nálezu, bez čekání na ostatní.
- Loop-until-green až v pěti kolech s opravami podle vlastníka souborů a potvrzení, že testy nikdo neoslabil.
- Postupné nasazení po krocích secrets, HA, zálohy, každý s ověřením zápisu zpět, a při selhání se zastaví.
- Chaos testy. Neinvazivní kontroly běží paralelně, ale výpadky peerů, rolling restart a degradované zálohy se pouští sériově, nikdy dva výpadky najednou.
- Crosscheck. Skeptici znovu přepočítají každý test, který hlásí úspěch.
Úplný rozpis všech agentů je na obrázku níže. Kliknutím se otevře v plné velikosti.
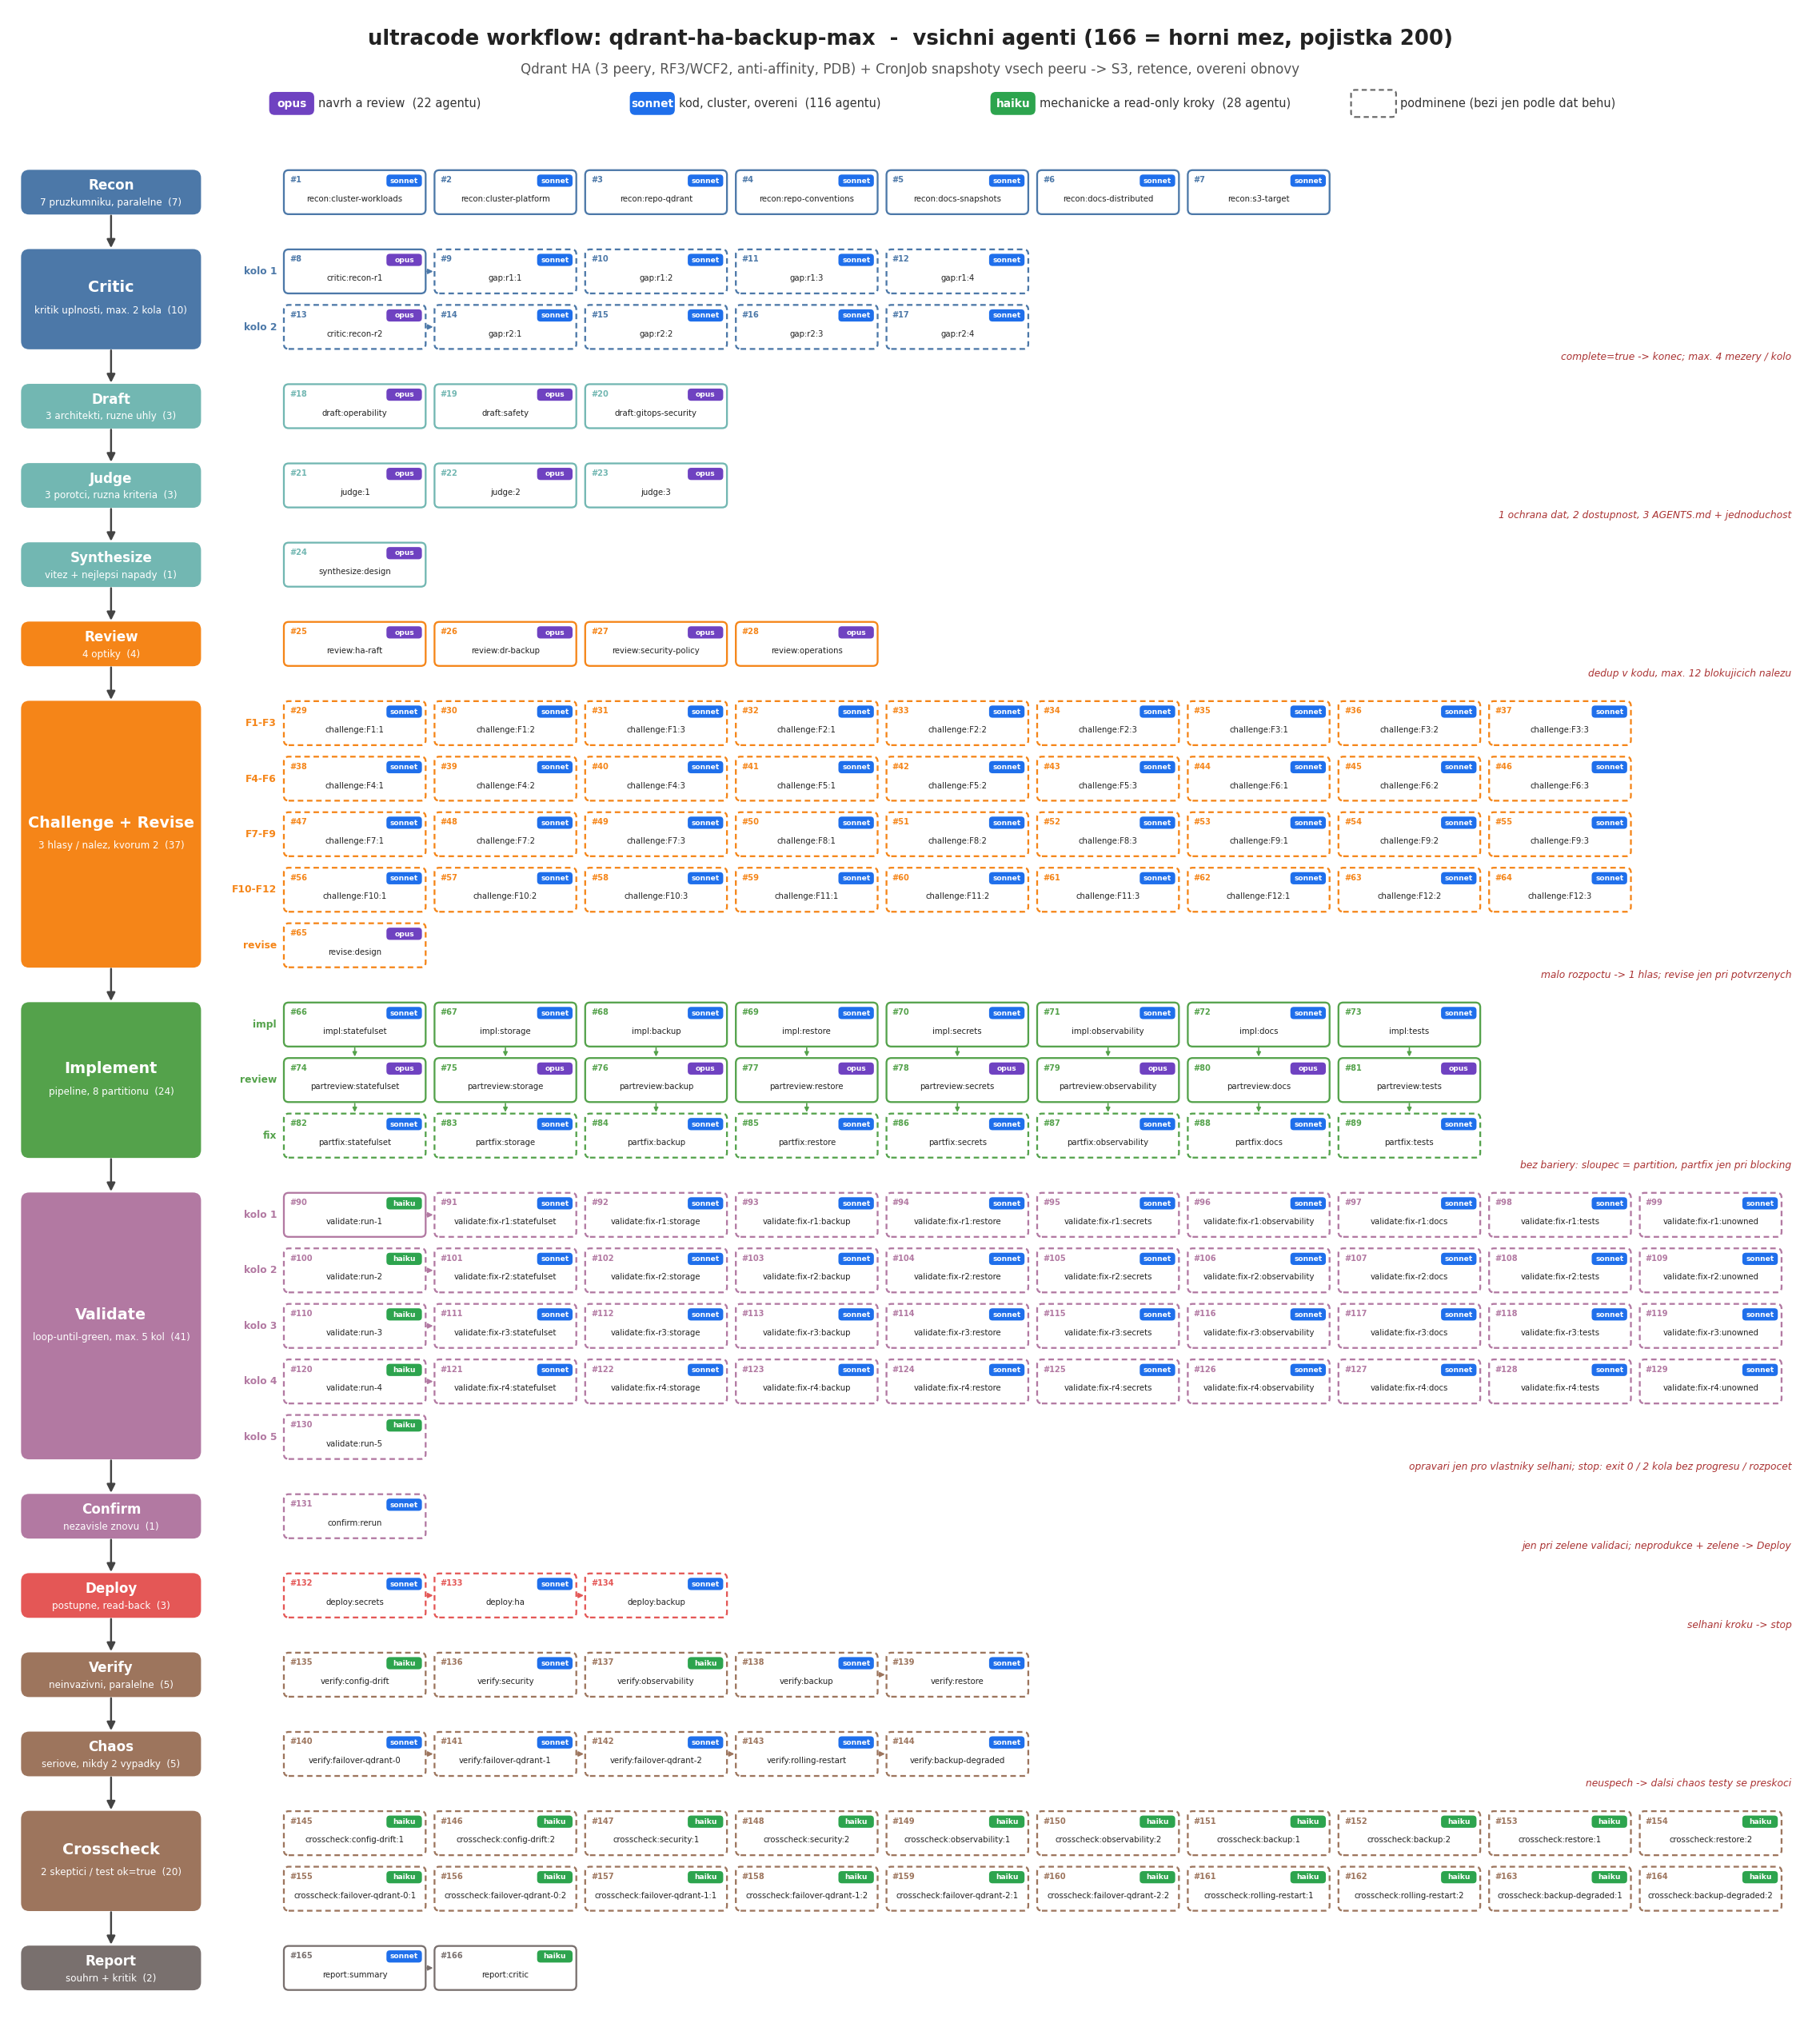
Srovnání tří variant
| 10 agentů | 20 agentů | Bez limitu | |
|---|---|---|---|
| Agentů | 10 | až 18 | až 166 (pojistka 200) |
| Průzkum | 2 agenti | 3 agenti | 7 agentů a kritik úplnosti |
| Návrh | 1 architekt | 1 architekt | 3 návrhy, 3 porotci, syntéza |
| Review | 1 skeptik | 2 skeptici | 4 optiky, kvórum nad nálezy |
| Implementace | 2 partitiony | 4 partitiony | 8 partitionů v pipeline s review |
| Validace | 1 oprava | 2 kola | až 5 kol, opravy podle vlastníka |
| Nasazení | jeden krok | jeden krok | 3 kroky s ověřením zpět |
| Ověření | 1 agent, 3 testy | 3 nezávislé testy | 5 kontrol, 5 chaos testů, crosscheck |
| Report | skládá kód | 1 agent | souhrn a kritik reportu |
Co se liší oproti aplikaci pro ankety
- Roste ověřování, ne kód. U infrastruktury je výsledkem pár manifestů. Většina agentů navíc nic nevyrábí, jen zkouší, přepočítává a hlídá.
- Nasazení je nevratnější než kód. Zatímco špatný kód se opraví dalším commitem, špatně nasazený cluster nebo ztracená záloha ne. Proto největší varianta nasazuje po krocích a po každém čte stav zpět.
- Testy se mají dělat jinou rukou. V desítce testuje failover, zálohu i obnovu jeden agent. Od dvacítky je to oddělené a v největší variantě navíc každý kladný výsledek znovu přepočítá další agent.
- Prostředí samo omezuje paralelismus. Chaos testy nejde pouštět souběžně, tak se řadí sériově. Víc agentů tedy neznamená, že všechno poběží rychleji.
Závěry
Limit na počet agentů nemění jen rozsah práce. Mění tvar celého workflow.
- Strop se promítne do návrhu. Agent s limitem 10 vynechá celé kategorie práce: panely, kvórum, nezávislé potvrzení, e2e. Nesnaží se je do deseti slotů nacpat, rovnou je vypustí.
- Bez stropu agent přidává kontrolu, ne jen sílu. Víc agentů neznamená víc kódu. Většina přírůstku jde na ověřování: kdo kontroluje koho, kdo měří a kdo hlídá, aby se testy neoslabily.
- Limit musí být v kódu, ne v promptu. Prompt „použij nejvýš deset agentů“ se dá přečíst jinak. Počítadlo v
run()se přečíst jinak nedá a stejně tak ostatní pojistky (strop 180, maximum kol, kvórum). - Rozhodnutí patří do kódu. Ve všech variantách rozhodnutí (vítěz návrhu, deduplikace nálezů, podmínky ukončení) počítá obyčejný TypeScript. Agenti dostávají úzké úkoly a vrací strukturovaný výstup podle schématu.
- Stupňování má jasný vzorec. Deset agentů dá lineární průchod s jednou kontrolou, dvacet (u infrastruktury) rozdělí role a zavede nezávislé ověření, bez limitu přibudou panely, kvóra, opakování a křížové kontroly.
- Nezávislá kontrola je důležitější než počet agentů. I s deseti sloty zůstává oddělený reviewer, který nehodnotí vlastní práci. Další vrstvy dávají smysl tam, kde je chyba v produkci drahá.
Kdy kterou
Deset agentů je dobrá volba na prototyp, MVP a vše, co po sobě stejně projdu očima. Je jednoduchá, přehledná a pořád má jednu nezávislou kontrolu.
Dvacet agentů dává smysl, když má práce více oddělených částí a chci, aby je zkoušel někdo jiný než autor, ale pořád stačí jedno kolo úvah.
Variantu bez limitu volím, když nad výsledkem nebudu sedět a potřebuju, aby věc došla do stavu, který ověřilo víc nezávislých pohledů, než ji uvidím.
Do volby navíc vstupuje ještě jedna praktická věc, a to tokeny. Každý agent navíc něco stojí a kola úvah bez limitu umí spotřebu rychle vyhnat nahoru. Kdybych stavěl jadernou elektrárnu, chtěl bych, aby se to udělalo poctivě, a na tokeny nehledím. Když ale mám tokenů omezeně, sáhnu radši po menší variantě a zbytek kontroly udělám sám.